EC サイトの商品情報も取りたくなった。基底クラスにも既存のスクレイパーにも手を入れず、新しい ProductScraper を1つ足すだけで対応する。最初のコピペ版ならどこを直す必要があったかと比べ、開放閉鎖原則(OCP)を確かめます。
サイトの構造が変わって要素が見つからなくても、スクレイパーは空の結果をそのまま保存して終わる。処理の流れに validate_data() を差し込み、既定では何もせず、必要な子クラスだけが検証を書けるようにします。空の HTML で検出できることも確かめます。
ほとんどのスクレイパーは同じ保存方法で足りるのに、子クラスごとに save_data() を書かされる。親クラスに既定の保存処理を用意し、変えたい子クラスだけが上書きするフックメソッドにします。抽象メソッドとの違いも整理します。
ニュースと天気予報で違うのは、HTML から何を抜き出すかだけ。基底クラスを extends で継承し、extract_data() と save_data() だけを子クラスでオーバーライドする。コピペ版と並べて、書く量と直す場所がどう変わったかを確かめます。
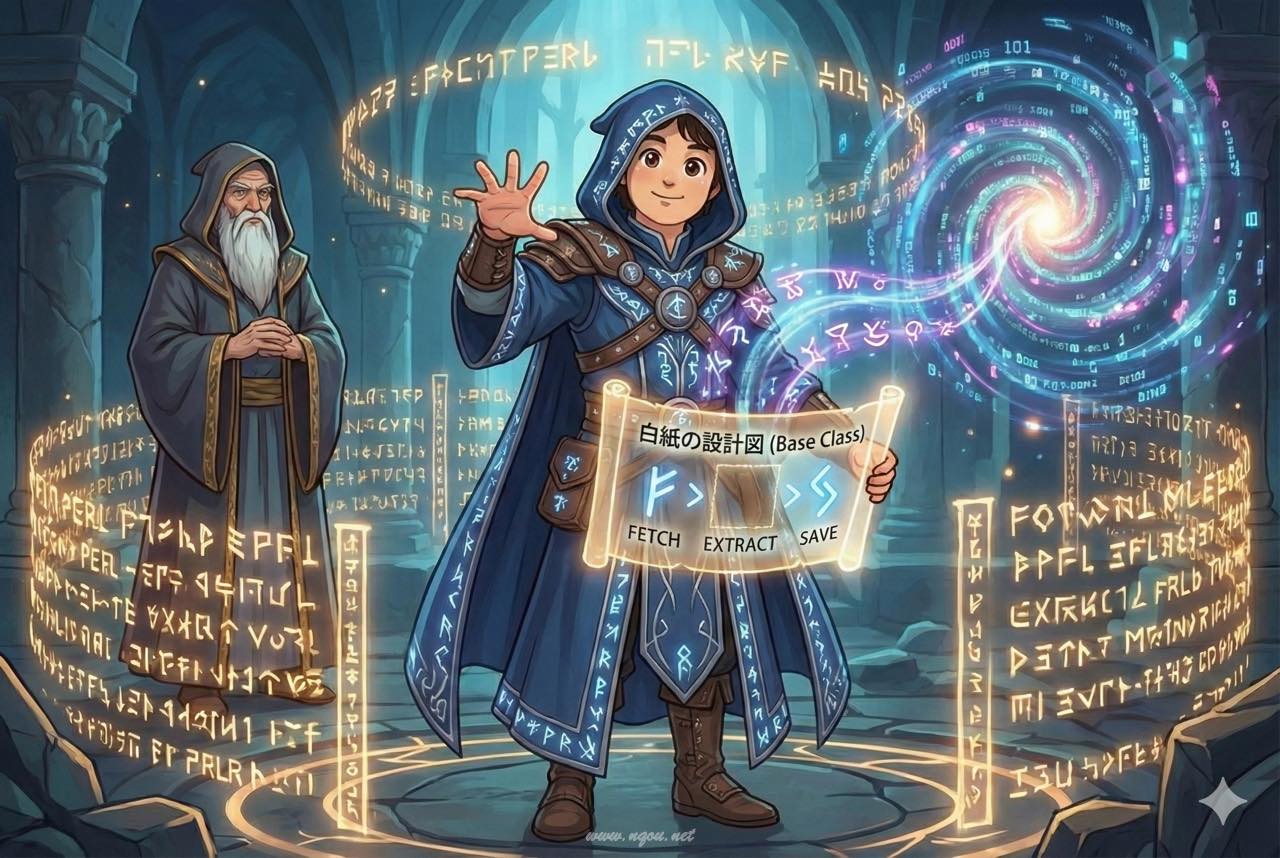
「取得→抽出→保存」の順番をスクリプトごとに書いていると、流れを変えるたびに全部を直すことになる。Moo の基底クラスの scrape() に流れを1つだけ書き、サイトごとに違う処理は抽象メソッドとして子クラスに任せます。
2本のスクレイパーに共通する「取得→抽出→保存」の流れを関数に切り出し、重複を減らす。それでも保存方法の切り替えや取得前後の処理は入れにくいまま残る。関数だけでは解けない問題がどこにあるかを確かめます。
ニュース用のスクレイパーをコピペして天気予報用を作ると、ほとんど同じコードが2本並ぶ。エラー処理を1つ直すにも全部を触り、バグはコピー先に残る。何が重複していて何が違うのかを洗い出し、このままでは破綻する理由を確かめます(DRY 原則)。
ニュースサイトの見出しを、Perl のスクリプトで取ってくる。Mojo::UserAgent で HTML を取得し、Mojo::DOM の CSS セレクタで要素を抜き出す基本を、アクセスのマナーと合わせて押さえます。
ハニーポットに届く侵入ログを、Perl と Moo で脅威スコアやアラートまで連動して動かす侵入レーダーに育て、最後に Observer パターンと名前を付ける全10回の連載の目次です。どこから読むか、困りごとからも選べます。
シリーズで作った IntrusionHub と通知係が、Observer パターンの Subject と Observer にどう対応するかを表で整理します。Pub/Sub との違いや、注意点・デメリットも確かめます。
RadarLogObserver・ThreatScoreObserver・RiskLevelObserver・AlertObserver を IntrusionHub に束ね、侵入イベントを流して動かします。シリーズで作ってきた全クラスの完成コードと実行結果を載せます。
脅威スコアに応じてリスクレベルを表示する RiskLevelObserver を、新しいクラスとして追加します。IntrusionHub や既存の通知係に手を入れずに機能が増えることを、開放閉鎖の原則(OCP)に沿って確かめます。
IntrusionHub の attach で、FakeObserver のような IntrusionObserver ロールを持たないオブジェクトを登録すると、通知時に初めて落ちます。does メソッドで登録時に検査して弾く方法を確かめます。
AlertObserver を追加し、日中はログとスコアだけ、深夜帯はアラートも加える、という運用を実現します。IntrusionHub に通知係を実行中に登録・解除して、コードを書き換えず通知先を切り替えます。
複数の通知係を束ねる IntrusionHub クラスを作り、attach で登録、detach で解除、notify で全員に一斉通知します。侵入イベントが起きたときの呼び出しが、1行に収まることを確かめます。